Notre actu
02
10
2026
Comment nous avons bâti notre agrégateur de sondages de la présidentielle 2027
par
Nina Godart, journaliste data
par
Yann Guégan, journaliste chargé de l'innovation éditoriale

by
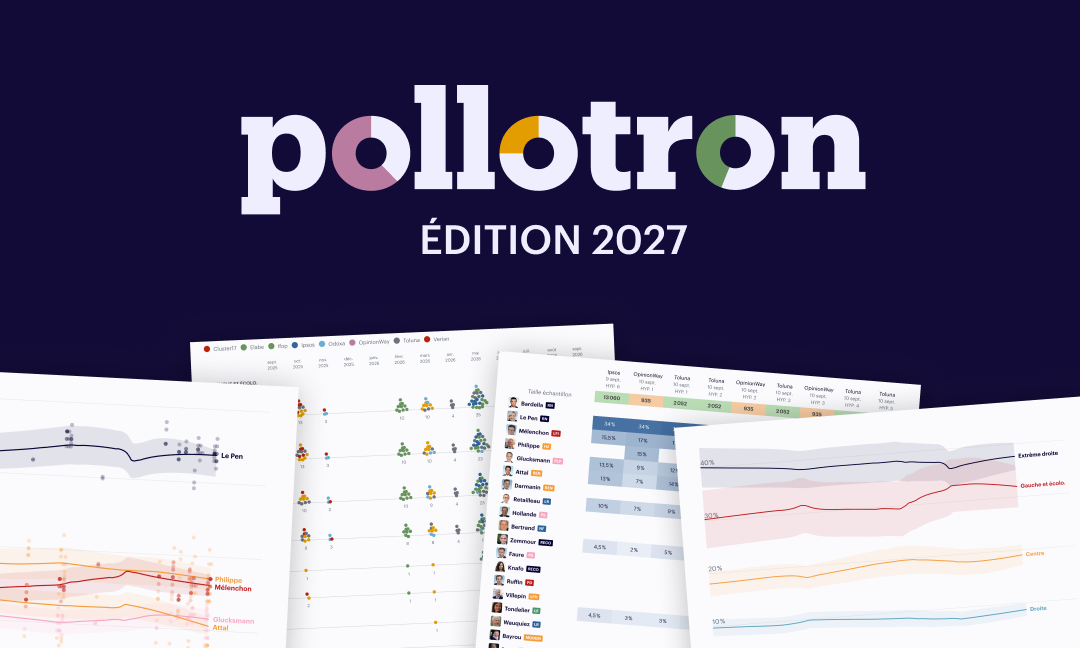
Les sondages, et particulièrement ceux qui simulent l’élection présidentielle, sont une source infinie de commentaires pour les personnalités politiques et les éditorialistes. Mais ils sont aussi l’objet de critiques, notamment quand le résultat de l’élection est éloigné des projections qui l’ont précédée. Plutôt que de suivre au coup par coup les études diffusées par un sondeur en particulier, Contexte a choisi de les agréger toutes. Ça donne le Pollotron, notre agrégateur de sondages de la présidentielle 2027. Pourquoi et comment l’avons-nous bâti ? Nous vous détaillons notre méthodologie dopée à l’IA dans ce billet.
Genèse
Est-il antinomique, pour un média comme Contexte dont la vision de l’info valorise la profondeur, la rigueur et le temps long, de scruter les sondages pendant de longs mois ? Notre ambition, avec cet agrégateur : éviter de commenter un point de hausse ou de baisse, souvent compris dans la marge d’erreur. Il s’agit plutôt de laisser de côté l’écume pour comprendre où va la vague.
À l’occasion de l’élection présidentielle de 2022, le datajournaliste Alexandre Léchenet avait récupéré manuellement tous les résultats des sondages d’intention de vote de tous les instituts recensés par la Commission des sondages. Contexte avait utilisé ces données pour publier un tableau de bord avec les scores moyens, courbes de tendance, scores minimum et maximum. Le Pollotron 2022 avait rencontré son public. Nous avons donc souhaité réitérer l’expérience à l’occasion de ce nouveau scrutin, mais cette fois en collectant nous-mêmes les données. Et pourquoi pas avec l’aide de l’IA ?
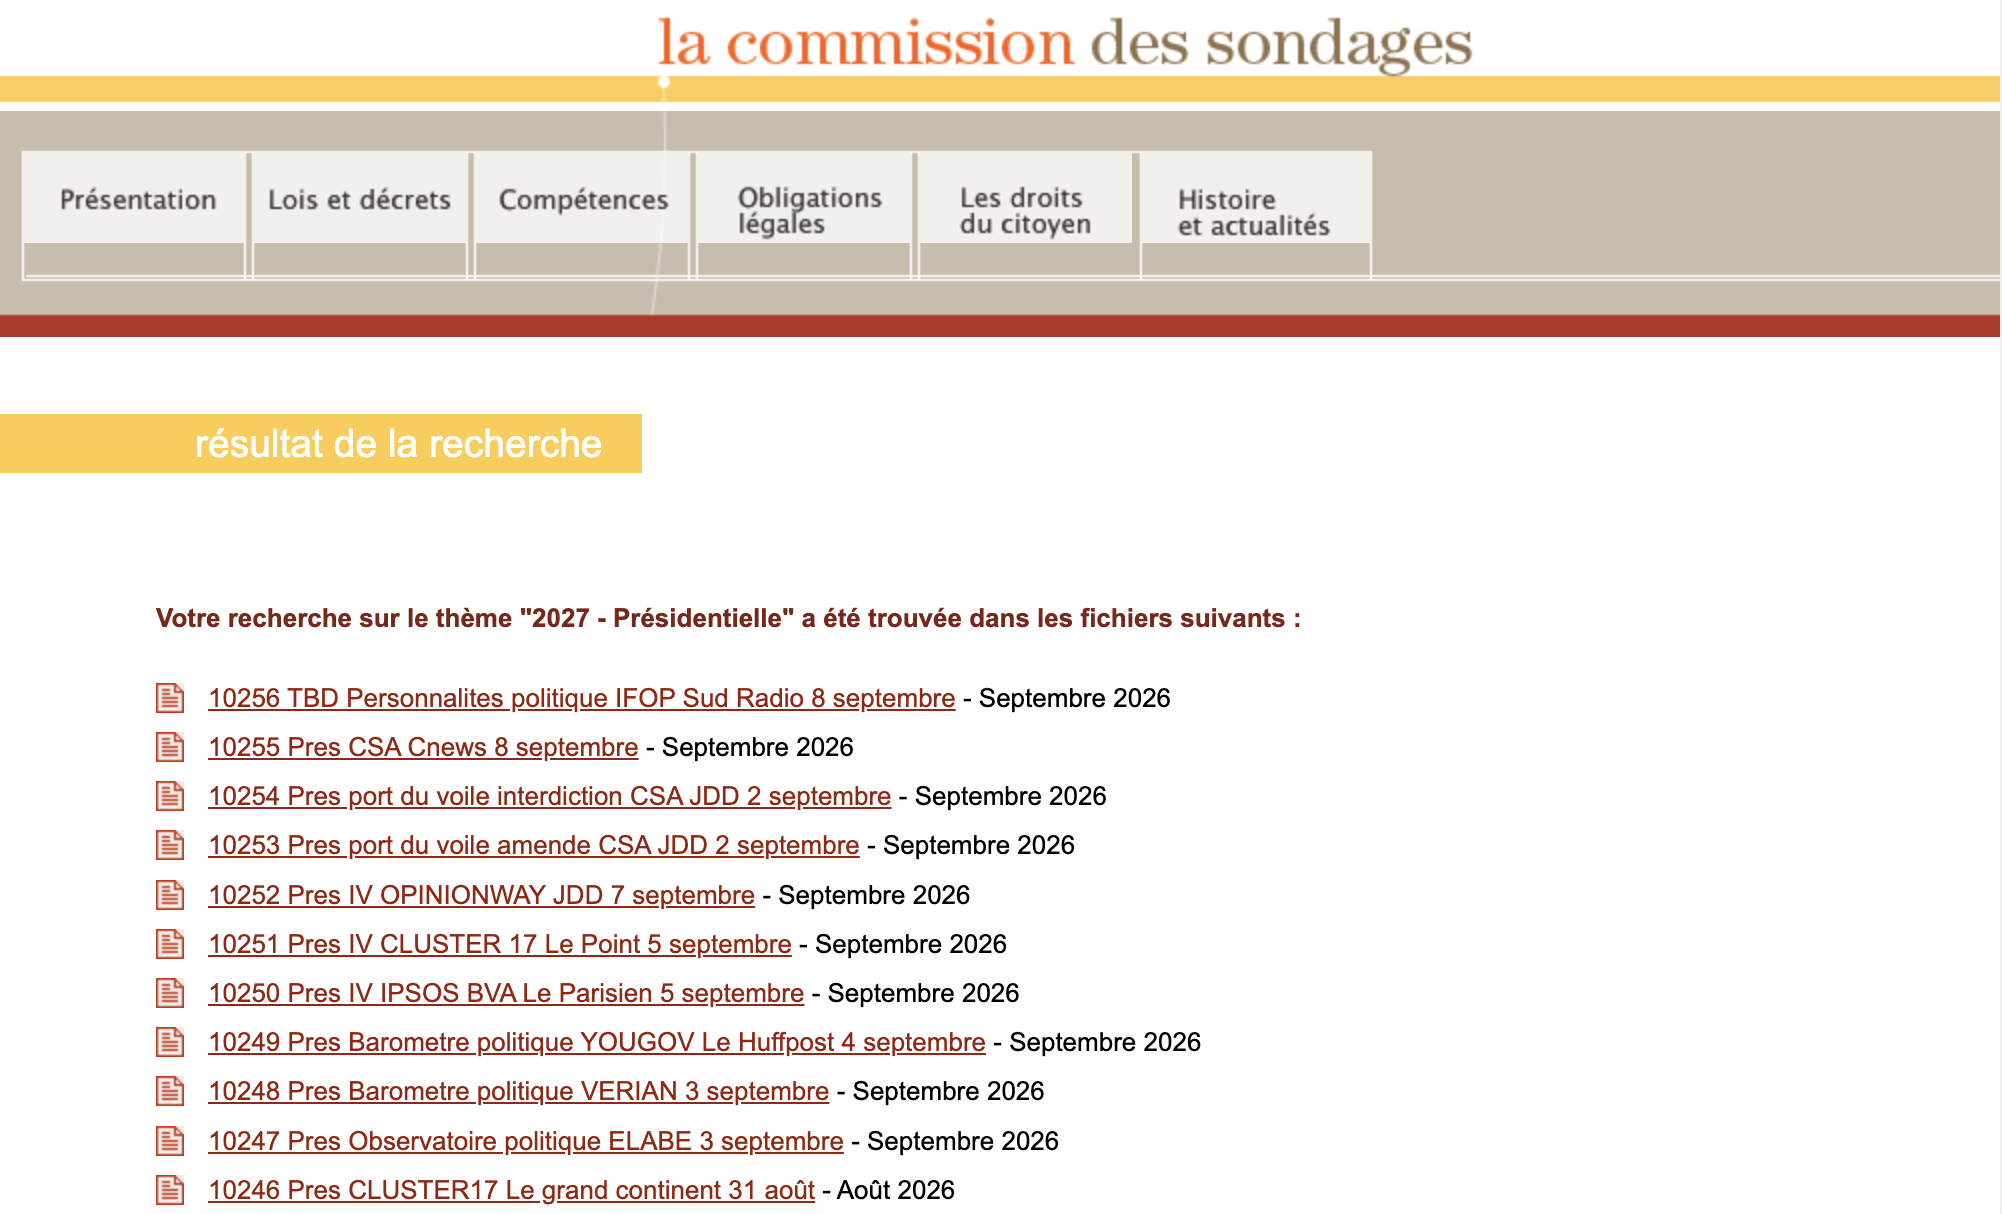
Ce travail a été rendu possible en extrayant les chiffres des enquêtes publiées sur le site de la Commission des sondages. Les résultats obtenus permettent de déterminer la courbe de tendance d’un candidat. Ce calcul est une façon de montrer le « signal » (soit le « vrai » état de l’opinion des électeurs) au milieu du « bruit » (la multitude des sondages et de leurs hypothèses, dont les résultats sont forcément irréguliers). Il est utile pour corriger les biais propres à chaque sondage, mais ne peut rien si toutes les entreprises font la même erreur, par exemple surestimer le score d’un candidat. Le résultat pourra frustrer les commentateurs : souvent, les courbes évoluent peu, la méthode choisie « amortissant » l’effet des « outliers », ces scores très hauts ou très bas par rapport au reste des résultats.
Premiers pas
La première étape a consisté à déterminer les éléments dont nous avions besoin pour bâtir l’agrégateur. Nous en avons identifié neuf :
- Numéro du sondage
- Nom de l’institut
- Commanditaire
- Échantillon
- Période d’enquête
- Hypothèse
- Candidat
- Score redressé
- Score minimum et maximum
Le site de la Commission des sondages centralise tous les sondages, puisque les instituts ont l’obligation légale de publier la méthodologie de ceux qui concernent une élection. Rapidement, nous nous apercevons qu’il y a du tri à faire : sur la page « 2027 – Présidentielles », on trouve des sondages sur des amendes contre le port du voile, la gestion des violences après la victoire du PSG en Ligue des champions ou la popularité de Sébastien Lecornu.
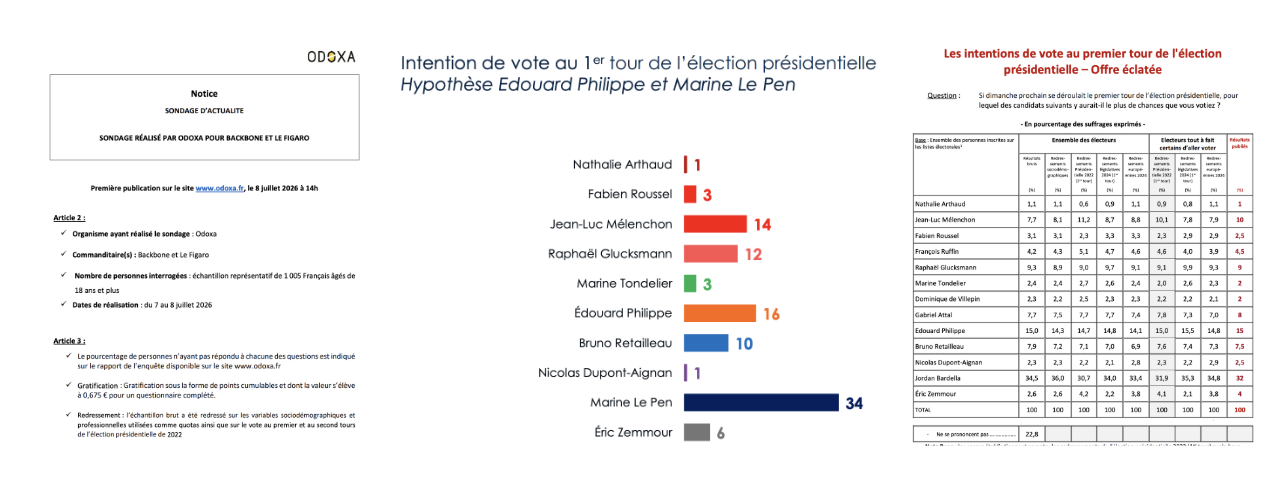
En épluchant les PDF qui étudient les intentions de vote, il ressort que la mise en forme change d’un institut à l’autre. Les intentions de vote peuvent être récapitulées en graphiques ou en tableaux. Parfois, les hypothèses testées sont détaillées au début du document et les résultats associés sur d’autres pages éloignées. Enfin, l’un des instituts publie uniquement sa notice sur le site de la Commission des sondages. Pour obtenir les données correspondantes, il faut aller fouiller le site dudit institut.
Team building avec Claude
Tentative numéro 1 : prendre Claude par la main
Pour les quatre premiers instituts, tout est expliqué à Claude : « Tu vas trouver l’échantillon après cette phrase, la période ici, l’hypothèse là, les résultats sous telle forme. » On coconstruit des scripts de récupération des données (scraping) à base d’expressions régulières : les regex. Ce sont des suites de caractères nébuleux (des slashs inversés, des dollars, des astérisques) qui servent à chercher un motif précis dans un texte. C’est plutôt convaincant, mais il y a des petites erreurs. Par exemple, Nathalie Arthaud devient « PUBLIÉ NATHALIE ARTHAUD ». La regex prend le titre de la deuxième colonne du tableau de résultats, « publié », pour le début du nom de la candidate d’extrême gauche.
Tentative numéro 2 : laisser Claude se débrouiller
Pour les quatre autres instituts, on demande à Claude de nous montrer l’étendue de ses talents. Le prompt se borne à lui enjoindre d’aller sur le site de la Commission, d’y trouver les sondages qui contiennent des intentions de vote et de récupérer telles et telles infos dans un tableur.
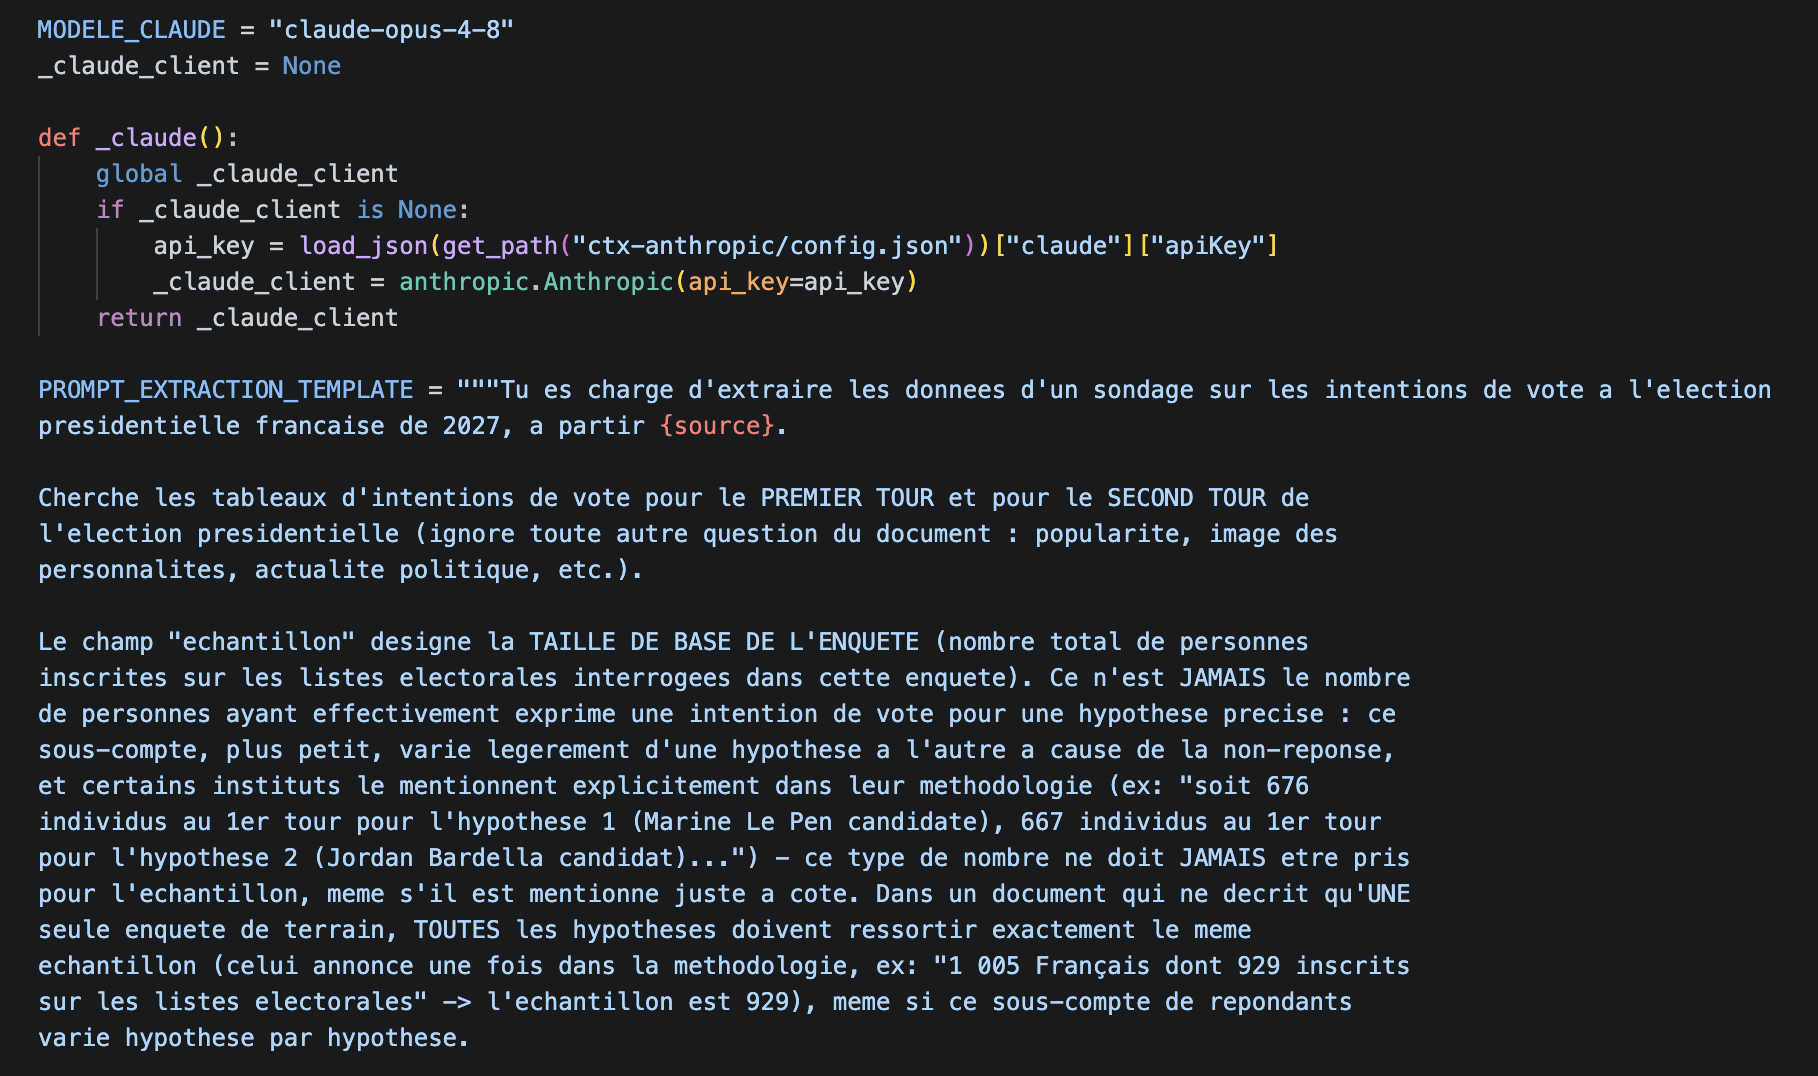
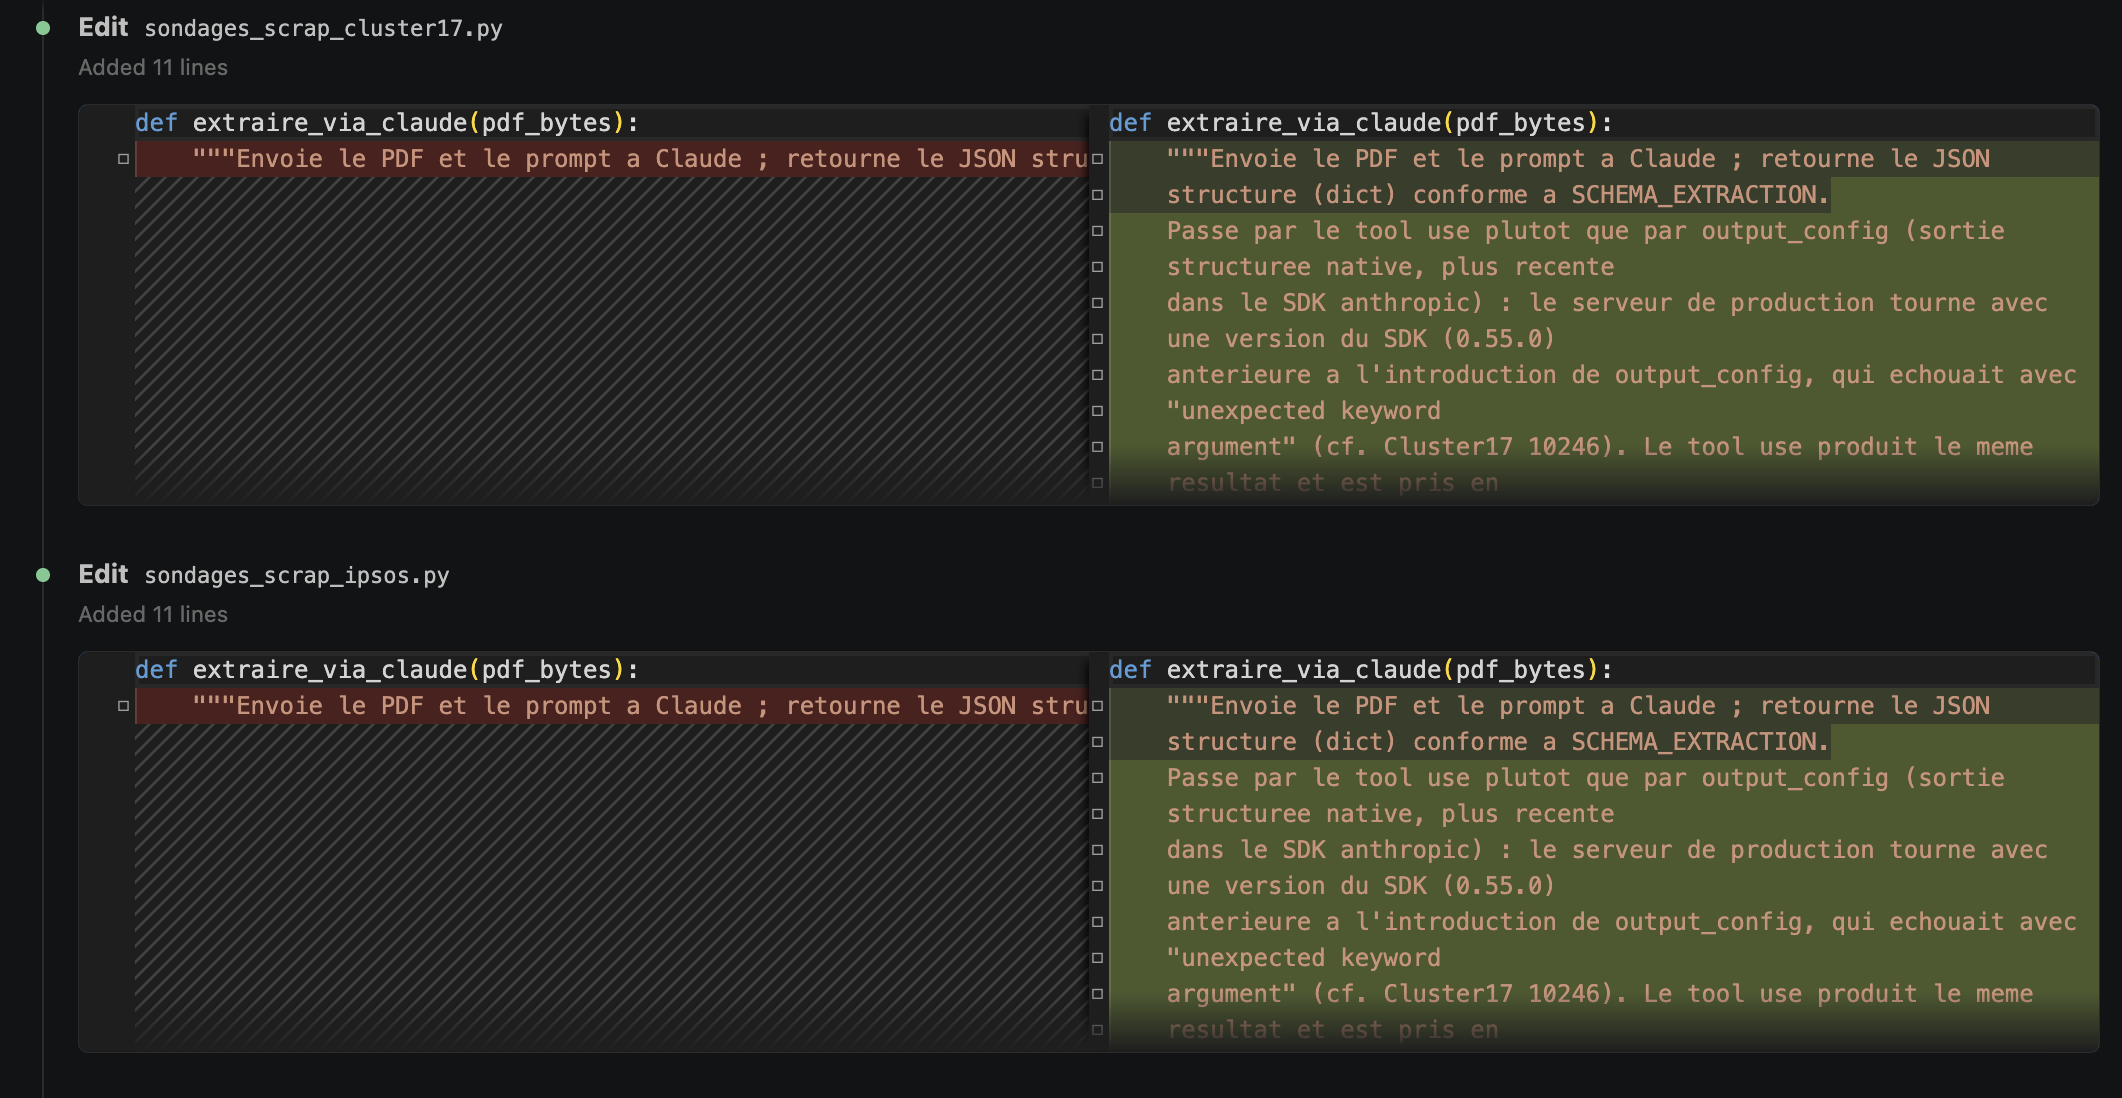
Pendant quelques semaines, quatre scripts sur huit scrapent avec des regex, quatre autres avec Claude, qui fait sa propre cuisine pour nous rapporter les infos. Les rares erreurs de scraping viennent uniquement des scripts qui utilisent les expressions régulières. Forcés d’admettre que Claude s’en sort beaucoup mieux quand on le laisse faire, nous convertissons donc tous les scripts au prompt.
Double vérification des résultats
Jusqu’ici, nous vérifions tous les résultats à la main. Mais comment industrialiser un mode de vérification, en prévision de mois où plusieurs sondages vont paraître chaque jour ? Nous avons étudié plusieurs options. Par exemple, faire tourner des centaines de milliers de fois le script sur le même PDF, comparer les résultats entre eux et calculer un taux d’erreur en fonction d’éventuelles variations. Mais quel taux d’erreur serait « acceptable » ?
Finalement, nous optons pour une double vérification : par la machine, mais aussi… humaine. La première intervient juste après le scraping. Claude reprend le PDF et le compare aux résultats du scraping. Au départ, il nous signale une erreur lorsqu’il y a un gros écart de score pour un même candidat d’une hypothèse à une autre. Or ce n’est pas une erreur : Édouard Philippe fait des sauts de plus ou moins dix points en fonction de qui est testé face à lui.
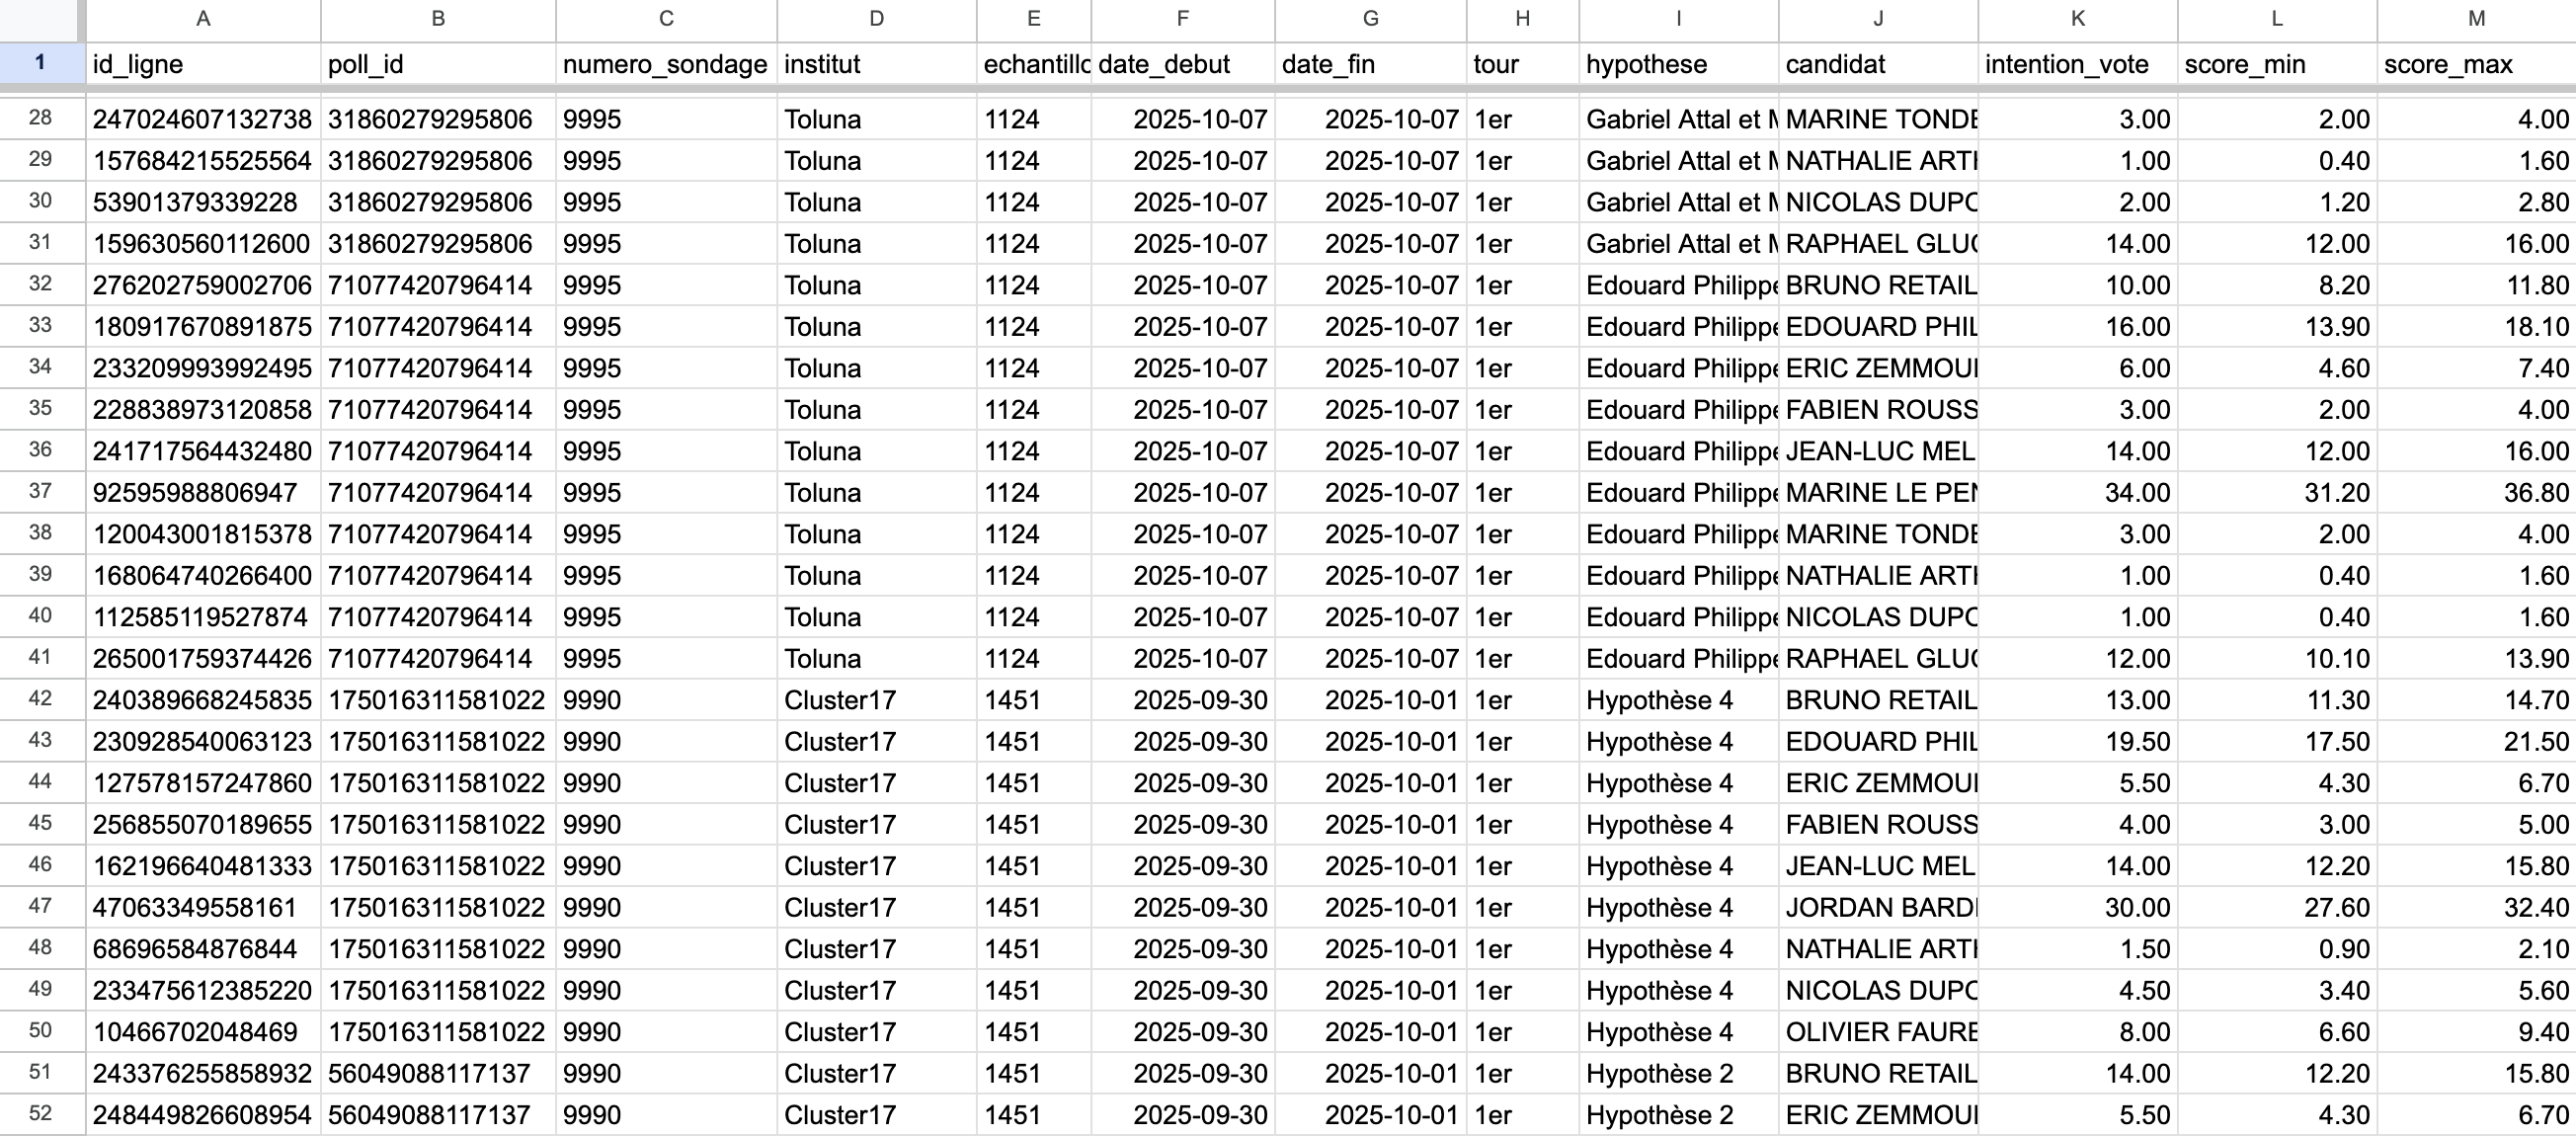
La seconde vérification, humaine, est également la plus cruciale. Marylène Truc, notre collègue documentaliste super méticuleuse, vérifie tout ligne par ligne et nous alerte en cas d’erreur. Ce n’est que lorsqu’elle a tout contrôlé que les sondages sont ajoutés au fichier final. Celui que nous mettons en open data et dont on se sert pour bâtir le Pollotron et demain d’autres potentielles infographies…
Utilisation des données
Le Pollotron, consultable en accès libre sur le site de Contexte, monitore en temps réel l’évolution des tendances par candidat et par famille politique.
Chez Contexte nous utilisons ces données pour analyser l’évolution des rapports de force, mais aussi les biais des instituts, ou encore les hypothèses qui avantagent certains candidats.
Parce que nous souhaitions que tout le monde puisse en tirer des visualisations et analyses, nous avons fait le choix de mettre à disposition les données récupérées par Contexte en open data sous la forme d’un fichier CSV sous la licence ODbL 1.0. Toute réutilisation doit s’accompagner de la mention suivante : « Données : Contexte » (avec un lien vers contexte.com/pollotron). À vous de jouer !
,
PLUS D'ACTUALITÉS